
导读: TP官网下载的数据怎么提取?这几步实操方法帮你快速搞定想把这些原始数据变成可用的分析素材,提取和清洗是关键一步。我处理TP官网数据始终围绕三件事:确认文件结构、锁定目标字段、用脚本批量解析。拿TP官网页面上公示的汇总数字,和你提取结果的求和值对比,误差超过0.你手头那份TP官网下载的数据,目前卡在哪...
TP官网下载的数据怎么提取?这几步实操方法帮你快速搞定
从TP官方网站下载的数据文件,多以压缩包或批量表格形式呈现,直接打开后信息散乱、字段不统一,离能用的状态差得远。想把这些原始数据变成可用的分析素材,提取和清洗是关键一步。我处理TP官网数据始终围绕三件事:确认文件结构、锁定目标字段、用脚本批量解析。
打开下载包后,先用浏览器或文本编辑器预览文件格式。TP官网的数据多为CSV或JSON两种,编码方式要特别留意,中文内容一般是UTF-8,遇到乱码就换GBK试试。碰到JSON嵌套结构,用pandas的json_normalize一行拍平成表,比手动逐层拆解快得多。
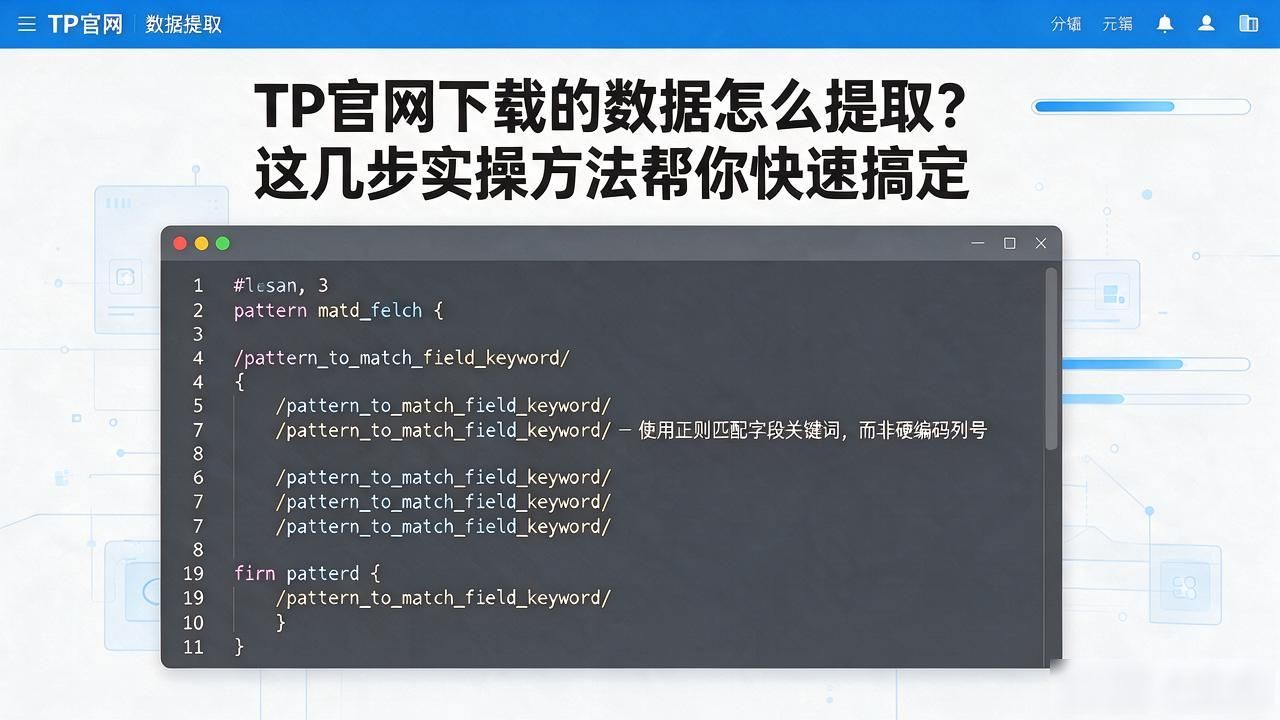
字段对齐是最耗时的环节。TP官网不同批次下载的数据如何从TP官方网站下载中提取数据,列名和顺序都可能微调,建议写一个自动映射脚本,用正则匹配字段关键词而非硬编码列号。官网下次更新字段名时,只需调几行映射规则就能跑通,不用把整个流程推倒重来。
提取完数据后,别忘了做交叉校验。拿TP官网页面上公示的汇总数字TP官网下载的数据怎么提取?这几步实操方法帮你快速搞定,和你提取结果的求和值对比,误差超过0.1%就回头查是不是漏了分页数据。你手头那份TP官网下载的数据,目前卡在哪一步?是格式打不开,还是字段对不上?
转载请注明出处:tp官方正版下载,如有疑问,请联系()。
本文地址:https://xttbez.com/tpzb/7457.html